LLM SEO : comment les moteurs de recherche IA lisent votre contenu
LLM SEO : RAG, passages, embeddings, Knowledge Graph et entités. Comprenez comment Gemini, Perplexity et Claude lisent vos pages, avec une checklist.

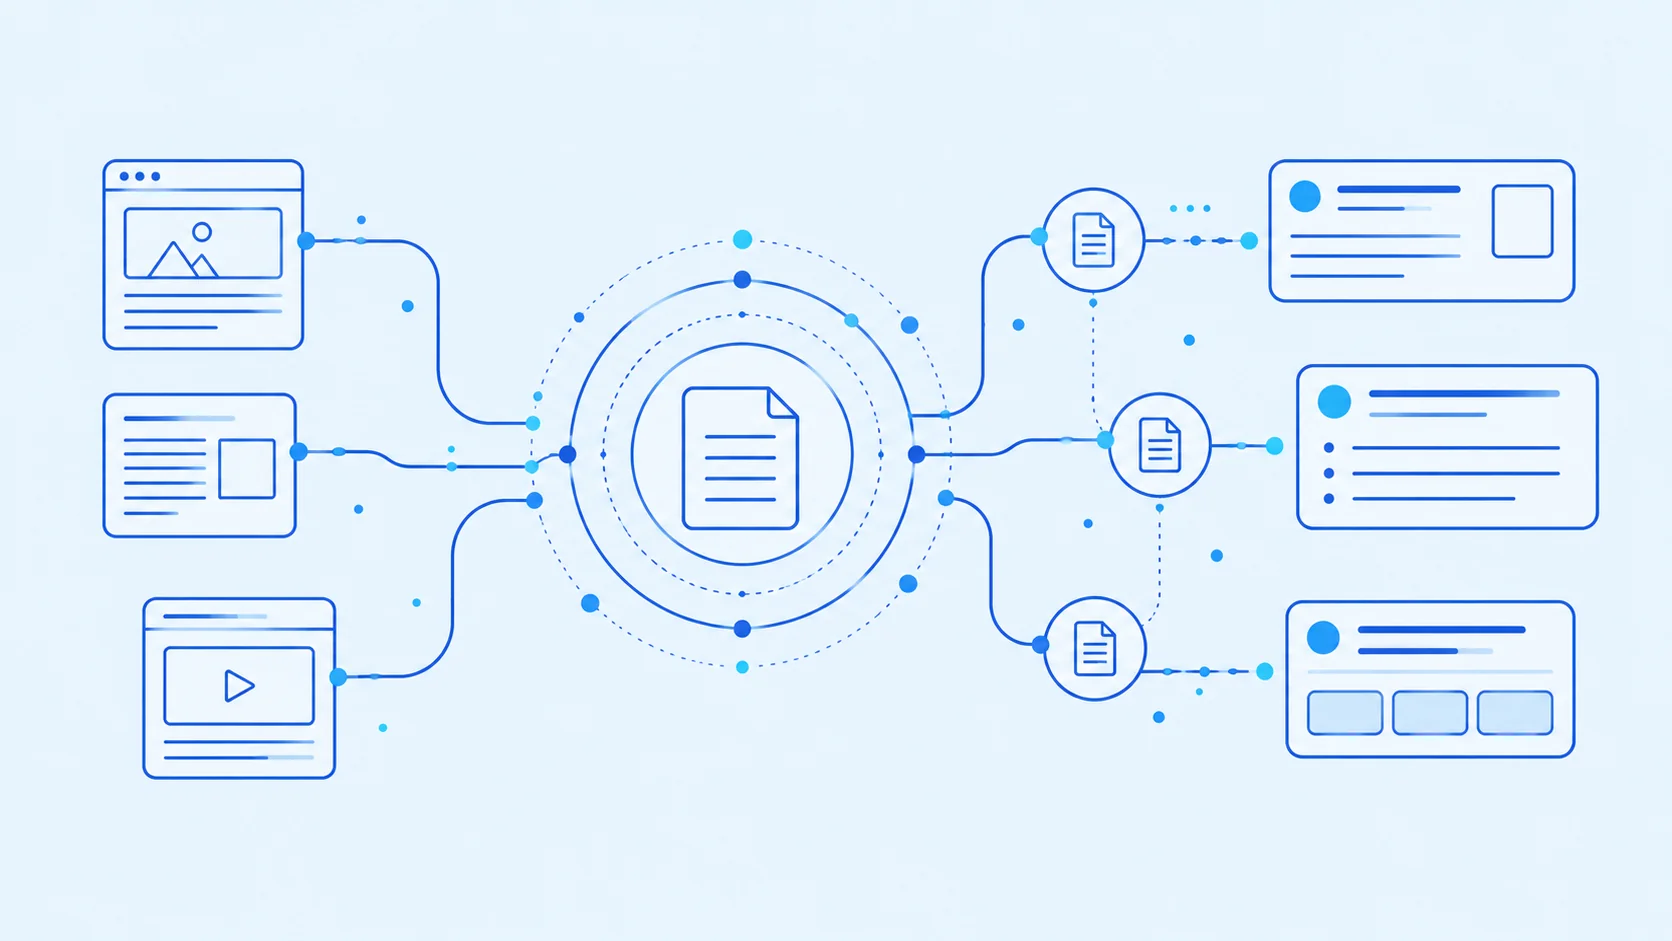
Le « LLM SEO » désigne l’optimisation d’un contenu pour la façon dont les grands modèles de langage (LLM) le récupèrent, le comprennent et le reprennent dans leurs réponses. Un moteur de recherche IA ne lit pas une page comme un internaute : il la récupère via un robot ou un index, la découpe en passages, la convertit en représentations mathématiques du sens, sélectionne les passages les plus pertinents, puis rédige une réponse en citant certaines sources. Comprendre ces étapes permet de savoir ce qui aide réellement (accès technique, passages clairs, entités bien identifiées) et ce qui relève du mythe. Voici le fonctionnement, notion par notion, et une checklist pour vos pages.
Cet article fait partie de notre série consacrée à la visibilité dans les moteurs génératifs, regroupée sur notre page GEO.
01LLM SEO : de quoi parle-t-on ?
« Comment s’appelle le SEO pour l’IA ? » figure parmi les questions associées de Google, et la réponse n’est pas unique. On parle de GEO (Generative Engine Optimization), d’AEO (Answer Engine Optimization), de LLMO ou de LLM SEO. Ces termes se recoupent. Le LLM SEO met l’accent sur un point précis : la mécanique de lecture des modèles, c’est-à-dire ce qui se passe entre le moment où un robot accède à votre page et le moment où une phrase de votre contenu apparaît, reformulée ou citée, dans une réponse.
Pour Google, ces approches ne constituent pas une discipline à part. Son guide d’optimisation pour les fonctionnalités d’IA générative de la recherche Google, mis à jour le 10 juillet 2026 et disponible en français, indique qu’optimiser pour la recherche générative reste du SEO, ce qui vaut pour l’AEO comme pour le GEO. Pour le cadre général et l’articulation avec le référencement classique, voir notre guide complet du GEO en 2026.
02Du crawl à la réponse : comment un moteur IA traite une page
Les éditeurs ne publient pas le détail de leurs systèmes. Les étapes ci-dessous décrivent le fonctionnement typique d’un moteur qui s’appuie sur la recherche pour répondre, tel que le décrivent la documentation de Google et la littérature technique sur la génération augmentée par récupération.
1. Récupérer : robots, index et rendu
Le moteur doit d’abord disposer de votre page. Soit il la trouve dans un index de recherche (celui de Google pour Gemini, AI Overviews et AI Mode, un index propre ou celui d’un partenaire pour d’autres assistants), soit il l’explore avec son propre robot au moment de la question. Point critique : une analyse de Vercel et MERJ sur les robots d’IA, publiée en décembre 2024, a montré que les principaux robots d’IA, dont ceux d’OpenAI, d’Anthropic et de Perplexity, n’exécutaient pas le JavaScript. Un contenu qui n’apparaît qu’après exécution de scripts côté navigateur risque donc d’être invisible pour ces robots, alors que Googlebot, qui effectue un rendu, peut le voir.
2. Découper : passages et fragments
Une page entière est trop longue pour être traitée d’un bloc. Le système la segmente en passages, généralement en s’appuyant sur la structure du document : titres, paragraphes, listes. Google classe d’ailleurs des passages depuis 2021 (passage ranking) dans sa recherche classique. Conséquence : un passage doit être compréhensible seul. Une section qui commence par « Comme nous l’avons vu » ou qui dépend d’un tableau placé ailleurs perd son sens une fois isolée.
Exemple. Passage dépendant : « Comme expliqué plus haut, cette méthode prend environ deux semaines et coûte moins cher que la précédente. » Isolé, ce texte ne dit ni de quelle méthode il s’agit, ni à quoi elle est comparée. Passage autonome : « Un audit de logs serveur prend environ deux semaines sur un site de 50 000 pages : une semaine de collecte, une semaine d’analyse. » Le sujet, la durée et le périmètre sont dans la phrase. Les chiffres de cet exemple sont illustratifs : utilisez vos propres données.
3. Représenter : embeddings et sens
Chaque passage, comme chaque question, est converti en vecteur numérique (un « embedding ») qui encode son sens. Deux textes proches par le sens ont des vecteurs proches, même s’ils n’emploient pas les mêmes mots. C’est pourquoi le bourrage de mots-clés n’aide pas : ce qui compte est la proximité sémantique entre la question et le passage. Google précise dans son guide qu’il n’est pas nécessaire de capturer chaque variante de formulation, ses systèmes comprenant les synonymes.
Exemple : la question « comment savoir si Google voit ma page » et un passage intitulé « Vérifier l’indexation d’une URL avec l’outil d’inspection de Search Console » ne partagent presque aucun mot, mais leur sens est proche. Un système de recherche sémantique les rapprochera. À l’inverse, une page qui répète « indexation Google » vingt fois sans jamais expliquer la procédure sera moins pertinente pour cette question.
4. Sélectionner : pertinence et confiance
Parmi les passages candidats, le système retient ceux qui répondent le mieux, en tenant compte de signaux de qualité et de fiabilité de la source. L’étude publiée par Ahrefs le 15 avril 2026 sur 1,4 million de prompts ChatGPT illustre cette sélection : l’assistant récupère des dizaines d’URL par requête mais n’en cite qu’environ la moitié, et les pages citées ont des titres sémantiquement plus proches de la question que les pages écartées.
5. Générer et citer
Le modèle rédige enfin la réponse à partir des passages retenus et attribue certaines affirmations à des sources. Un passage peut être utilisé sans être cité, ou cité pour une seule phrase. Les formulations précises, datées et attribuables se prêtent mieux à la citation qu’un texte vague.
03RAG, Knowledge Graph, entités : les notions à maîtriser
Le RAG, ou génération augmentée par récupération
Le RAG (Retrieval-Augmented Generation) combine un moteur de recherche et un modèle de langage : au lieu de répondre de mémoire, le modèle s’appuie sur des documents récupérés au moment de la question. Google indique que ses fonctionnalités d’IA générative reposent sur ce principe, complété par le « query fan-out », qui génère des requêtes connexes pour couvrir les facettes d’une question. Pour un éditeur, le RAG a une conséquence majeure : votre contenu actuel peut être utilisé immédiatement, à condition d’être récupérable. Sans recherche, le modèle se limite à ce qu’il a appris pendant son entraînement, sur lequel vous n’avez pas de prise à court terme.
Le RAG change aussi la valeur de la mise à jour. Une information corrigée sur votre page peut être reprise dès que le moteur récupère la nouvelle version, alors qu’une erreur présente dans les données d’entraînement d’un modèle persiste jusqu’à la version suivante. Tenir à jour les pages qui décrivent votre offre, vos prix et vos conditions devient une tâche de visibilité, pas seulement de gestion de contenu.
Le Knowledge Graph et les entités
Le Knowledge Graph de Google, lancé en 2012 avec la formule « things, not strings », est une base de connaissances qui relie des entités (personnes, organisations, lieux, produits, concepts) par des relations. Une entité bien identifiée est plus facile à associer à un sujet et à distinguer de ses homonymes. Les modèles de langage manipulent eux aussi des entités et leurs relations, même si leur représentation interne diffère. Ce qui aide dans les deux cas : des noms constants, des relations explicites (« X, fondé en 2015 à Lyon, édite le logiciel Y ») et des sources externes cohérentes.
La saillance des entités dans un texte
La saillance mesure l’importance d’une entité dans un texte donné. L’API Cloud Natural Language de Google, par exemple, renvoie pour chaque entité détectée un score de saillance. C’est un bon outil de contrôle : si votre page sur « l’audit SEO technique » fait ressortir comme entité principale le nom de votre agence ou un outil cité en passant, le sujet de la page n’est pas assez clair. Gardez en tête que ce score reflète l’analyse de cette API, pas celle des moteurs IA : il sert d’indicateur, pas de cible.
04Ce que Gemini, Perplexity et Claude récupèrent réellement
Chaque assistant a son propre chemin d’accès au web. Savoir lequel conditionne vos réglages techniques.
- Gemini et les fonctionnalités IA de Google s’appuient sur l’index de Google. Les règles de Googlebot et les directives de snippet (nosnippet, max-snippet) s’appliquent à AI Overviews et AI Mode. Lors de la Google I/O du 19 mai 2026, Google a fait de Gemini 3.5 Flash le modèle par défaut d’AI Mode. Google précise que sa recherche n’utilise pas les fichiers llms.txt.
- Perplexity dispose de son propre robot, PerplexityBot, et affiche systématiquement ses sources. Selon l’étude Ahrefs du 11 août 2025 sur le recoupement entre citations IA et top 10 de Google, 28,6 % des URL qu’il cite figurent dans le top 10 de Google pour la même requête, le taux le plus élevé parmi les assistants étudiés.
- Claude : Anthropic documente trois robots distincts, ClaudeBot pour la collecte liée à l’entraînement, Claude-SearchBot pour la recherche et Claude-User pour les pages consultées à la demande d’un utilisateur. Anthropic a par ailleurs ajouté Brave Search à la liste de ses sous-traitants en mars 2025, ce qui indique que la recherche web de Claude s’appuie notamment sur cet index.
Aucun de ces éditeurs ne publie de liste de critères de sélection. Les affirmations du type « Claude privilégie tel format » ou « Perplexity favorise telle longueur » relèvent de l’observation, au mieux, et doivent être testées sur vos propres requêtes.
En pratique, commencez par un inventaire : quels robots d’IA visitent réellement votre site ? Vos journaux serveur (logs) le montrent, avec la fréquence des visites, les pages demandées et les codes de réponse. Un robot de recherche qui reçoit des erreurs 403 à cause d’une règle de pare-feu, ou qui ne visite jamais vos pages stratégiques, peut expliquer une absence de citation mieux que n’importe quel critère éditorial.
05Rendre votre contenu lisible par les modèles : checklist
- Contenu principal dans le HTML initial : rendu côté serveur ou génération statique pour les pages importantes. Vérifiez avec l’affichage du code source, pas seulement avec l’inspecteur du navigateur. Sur un site construit avec un framework JavaScript (React, Vue, Angular), activez le rendu serveur ou le pré-rendu au moins pour les pages de contenu, de catégorie et de produit.
- Robots autorisés en connaissance de cause : distinguez robots de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot) et robots d’entraînement (GPTBot, ClaudeBot), dans le robots.txt et dans les règles du CDN.
- Hiérarchie de titres explicite : un H2 par grande question, des H3 pour les sous-questions ou étapes. Les intertitres guident le découpage en passages.
- Passages autonomes : chaque section nomme son sujet et donne sa réponse dans les premières phrases.
- Entités constantes : même nom de marque, de produit et de personne partout, relations explicites, page « à propos » factuelle.
- Faits datés et attribués : « selon Google, juillet 2026 » plutôt que « récemment ».
- Listes et tableaux en HTML réel pour les étapes et comparaisons, jamais en image.
- Titre de page et URL en langage naturel, alignés sur la question principale.
Le guide Google rappelle aussi ce qui n’est pas nécessaire : découper artificiellement le contenu, le réécrire pour l’IA, ajouter un balisage spécial. Les données structurées restent utiles pour les résultats enrichis et pour clarifier les entités, mais elles ne sont pas requises pour les fonctionnalités d’IA générative. Pour les leviers éditoriaux qui favorisent la citation, voir notre guide pour être cité par ChatGPT, Perplexity et Gemini, et pour la logique de réponse directe, notre article sur l’AEO et les moteurs de réponse.
06Tester la lecture de vos pages par une IA
Quelques tests simples montrent ce qu’un modèle retient de vos pages.
- Test du texte brut : récupérez la page sans exécuter le JavaScript (par exemple avec
curl) et vérifiez que le contenu principal est présent. - Test du passage isolé : copiez une section seule et demandez à un assistant de résumer de quoi elle parle et à quelle question elle répond. Si la réponse est floue, la section dépend trop du reste de la page.
- Test des entités : passez le texte dans un outil d’extraction d’entités et comparez les entités principales détectées au sujet visé.
- Test de citation : posez à plusieurs assistants les questions auxquelles la page répond et relevez les sources citées. Répétez le test à intervalle régulier, les réponses variant d’une exécution à l’autre.
Pour le test du texte brut, une commande suffit :
curl -s -A "Mozilla/5.0" https://www.exemple.fr/ma-page/ | grep -c "phrase clé de votre contenu"Si le résultat vaut 0 alors que la phrase s’affiche dans le navigateur, le contenu est injecté par JavaScript. Pour le test du passage isolé, un prompt simple fonctionne : « Voici un extrait de page web. En une phrase, à quelle question répond-il ? Quelles entités principales mentionne-t-il ? » Comparez la réponse avec l’intention visée par la section.
Ces tests s’automatisent avec n8n : un workflow peut récupérer chaque URL stratégique, extraire le texte brut, vérifier la présence de passages clés, puis envoyer un panel de questions aux API des modèles et consigner les sources citées dans un tableur. Pour transformer ces relevés en indicateurs de suivi, consultez notre article sur la mesure de la visibilité de marque dans les IA.
07Idées reçues à écarter
- « Il faut écrire pour les robots » : les modèles comprennent le langage naturel. Un texte clair pour un lecteur expert l’est aussi pour eux.
- « Il faut découper le contenu en petits blocs » : Google indique que ce n’est pas nécessaire. Une structure logique suffit.
- « Le llms.txt est indispensable » : Google indique que sa recherche ne l’utilise pas. Pour les autres assistants, rien ne permet d’en faire une condition de citation : testez avant d’y consacrer du temps.
- « Répéter le mot-clé aide le modèle » : la recherche par proximité sémantique rend la répétition inutile, voire nuisible à la lisibilité.
- « Les modèles lisent tout le site » : ils récupèrent quelques pages, puis quelques passages. Vos pages stratégiques doivent chacune se suffire à elles-mêmes.
- « Un bon score d’optimisation IA garantit la citation » : aucun outil tiers ne connaît les critères internes des moteurs. Seuls vos tests répétés et vos données de visibilité font foi.
Le LLM SEO, bien compris, ne demande pas d’écrire autrement : il demande d’écrire plus clairement, de rendre le contenu accessible sans obstacle technique et de lever toute ambiguïté sur les entités. Ce sont ces trois conditions qui permettent à un moteur IA de lire votre contenu, de le comprendre et de le citer.
- Google Search Central : Guide to Optimizing for Generative AI Features on Google Search - optimiser pour la recherche générative reste du SEO, sans découpage du contenu, sans fichier llms.txt et sans données structurées obligatoires.
- Vercel : The rise of the AI crawler - en décembre 2024, les principaux robots d’IA, dont ceux d’OpenAI, d’Anthropic et de Perplexity, n’exécutaient pas le JavaScript.
- Ahrefs : Why ChatGPT Cites One Page Over Another (Study of 1.4M Prompts) - ChatGPT cite environ la moitié des URL qu’il récupère, et les pages citées ont des titres plus proches de la question.
- Claude Help Center : Does Anthropic crawl data from the web? - Anthropic distingue ClaudeBot (entraînement), Claude-SearchBot (recherche) et Claude-User (requêtes des utilisateurs).
- Google Blog : Introducing the Knowledge Graph: things, not strings - Google a lancé le Knowledge Graph en 2012 pour relier des entités plutôt que des chaînes de caractères.