RAG : comprendre simplement la génération augmentée appliquée au SEO
Le RAG relie un LLM à des sources externes pour produire des réponses sourcées. Fonctionnement, limites, usages SEO et GEO, et méthode pour un premier projet.

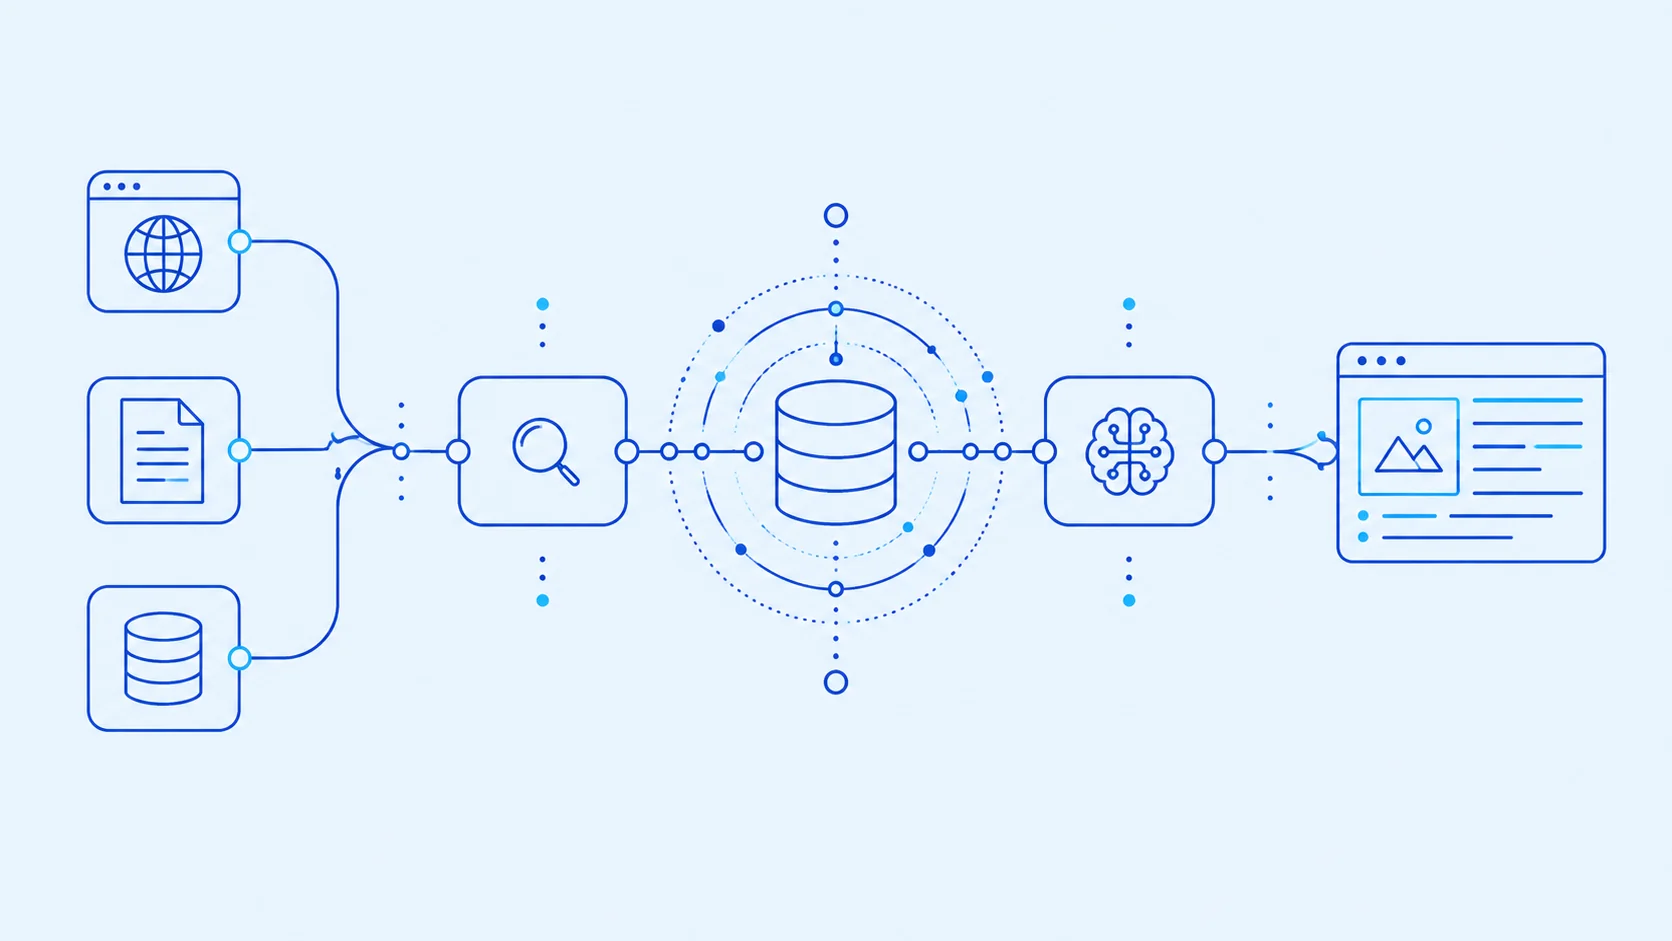
Le RAG (Retrieval-Augmented Generation, ou génération augmentée par récupération) est une technique qui fait chercher des informations dans une source externe avant qu’un modèle de langage ne rédige sa réponse. Au lieu de s’appuyer uniquement sur ce qu’il a appris pendant son entraînement, le modèle reçoit, au moment de la question, des passages extraits de documents choisis : pages web, base de connaissances, fiches produit, procédures internes. Le résultat est une réponse plus à jour, plus spécifique et, surtout, vérifiable par ses sources. Pour un responsable SEO ou contenu, le sujet a deux faces : le RAG sert à construire des assistants utiles sur vos propres données, et sa logique (récupérer, puis générer) éclaire la manière dont les moteurs IA sélectionnent les pages qu’ils citent. Voici une explication simple du fonctionnement, des limites réelles et des usages concrets.
01Qu’est-ce que le RAG en IA ?
Un grand modèle de langage (LLM) possède une connaissance figée à la date de son entraînement et ne connaît pas vos documents internes. Quand on l’interroge sur un sujet récent ou spécifique, il peut produire une réponse plausible mais fausse. Le RAG limite ce défaut par une étape de recherche documentaire placée avant la génération : le système identifie les passages les plus pertinents pour la question, les insère dans le contexte du modèle, puis demande à ce dernier de répondre à partir de ces passages.
Le terme vient d’un article de recherche publié en 2020 par Patrick Lewis et ses coauteurs, alors chez Facebook AI Research, présenté à la conférence NeurIPS : « Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks ». Les auteurs y combinaient une mémoire dite paramétrique (les connaissances stockées dans le modèle) et une mémoire non paramétrique (un index de passages de Wikipédia interrogé par un moteur de recherche neuronal). L’expression s’est ensuite élargie à toute architecture qui associe recherche et génération. En français, on rencontre « génération augmentée par récupération » ou « génération à enrichissement contextuel », titre de l’article de Wikipédia consacré au sujet.
Une précision pour lever une ambiguïté fréquente dans les recherches : en anglais, le mot « rag » signifie « chiffon ». Dans le contexte de l’IA, il s’agit uniquement de l’acronyme RAG.
L’image la plus juste reste celle de l’examen à livre ouvert. Le modèle sait rédiger et raisonner, mais on lui fournit les bonnes pages du manuel au moment de répondre. S’il reçoit les mauvaises pages, ou des pages périmées, sa réponse sera fausse avec la même assurance. C’est pourquoi la qualité d’un RAG se joue d’abord sur la recherche, bien avant le choix du modèle.
02Comment fonctionne un système RAG
Un système RAG repose sur deux phases distinctes : une phase d’indexation, réalisée en amont et mise à jour régulièrement, et une phase de requête, exécutée à chaque question.
1. Préparer et découper les documents
La première étape consiste à rassembler les sources autorisées : pages du site, PDF, articles d’aide, fiches produit, comptes rendus, exports de données. Il faut ensuite les nettoyer, c’est-à-dire retirer menus, pieds de page, bannières et doublons qui pollueraient la recherche. Les documents sont enfin découpés en passages (les « chunks »), de taille suffisante pour porter une idée complète, souvent avec un léger chevauchement pour ne pas couper une explication en deux.
Chaque passage reçoit des métadonnées : URL ou nom du fichier, titre de section, date de mise à jour, langue, type de contenu, niveau de confidentialité. Ces métadonnées servent plus tard à filtrer les résultats et à citer la source.
2. Indexer : embeddings et base vectorielle
Chaque passage est transformé en embedding, un vecteur numérique qui représente son sens. Deux passages qui traitent du même sujet, même avec des mots différents, obtiennent des vecteurs proches. Ces vecteurs sont stockés dans une base vectorielle, optimisée pour retrouver rapidement les vecteurs les plus proches d’une requête. Le choix du modèle d’embedding compte : il doit bien gérer la langue de vos contenus et votre vocabulaire métier.
3. Récupérer les passages pertinents
Quand l’utilisateur pose une question, celle-ci est convertie en vecteur avec le même modèle d’embedding. Le système récupère les passages dont les vecteurs sont les plus proches, en général quelques-uns seulement. Les dispositifs robustes ajoutent souvent :
- une recherche hybride, qui combine similarité vectorielle et recherche lexicale classique, utile pour les noms propres, références produit et codes ;
- des filtres sur les métadonnées (langue, date, gamme de produits, droits d’accès) ;
- un reranking, qui réordonne les passages candidats avec un modèle plus précis avant de les transmettre au LLM.
4. Générer une réponse sourcée
Le modèle reçoit enfin un prompt qui assemble des instructions, les passages récupérés et la question. Les instructions précisent en général de répondre uniquement à partir des passages fournis, de citer les sources et de dire clairement quand l’information manque. Exemple : à la question « quel est le délai de retour pour une commande en ligne ? », le système récupère le passage des conditions générales qui traite des retours, et le modèle répond en citant ce document plutôt qu’en généralisant à partir de pratiques courantes du e-commerce.
03RAG, LLM seul et fine-tuning : quelles différences ?
Le RAG n’est pas un modèle : c’est une architecture construite autour d’un modèle. La comparaison avec les autres approches permet de choisir la bonne solution selon le besoin.
- LLM seul : rapide à mettre en place, mais limité aux connaissances d’entraînement. Il ignore vos contenus internes et les faits récents, et ne peut pas citer de source fiable.
- RAG : ajoute une connaissance externe au moment de la question. Pour mettre à jour le savoir du système, il suffit de réindexer les documents. Les réponses sont traçables, ce qui facilite le contrôle.
- Fine-tuning : modifie les paramètres du modèle par un entraînement complémentaire. Il sert surtout à imposer un style, un format ou une tâche spécialisée, beaucoup moins à apprendre des faits qui changent souvent.
- Contexte long : coller directement tous les documents dans le prompt. Cela fonctionne pour un petit corpus, mais le coût et la dilution de l’attention augmentent vite avec le volume.
En pratique, ces approches se combinent. Un assistant de support peut utiliser un modèle affiné pour respecter le ton de la marque, et un RAG pour répondre sur les procédures en vigueur. Pour la plupart des besoins SEO et marketing, le RAG est le premier levier à tester, car il agit sur la qualité des faits sans exiger d’entraînement.
04Pourquoi le RAG concerne le SEO et le GEO
Les moteurs de réponse reposent sur une logique voisine : chercher des documents, puis rédiger une synthèse qui les cite. La documentation de Google sur les fonctionnalités d’IA indique que les AI Overviews et AI Mode peuvent utiliser une technique de « query fan-out », qui consiste à lancer plusieurs recherches liées sur des sous-thèmes et des sources de données pour construire la réponse, et que les modèles identifient des pages complémentaires pendant la génération pour afficher des liens. Google n’emploie pas le terme RAG dans ce document et ne détaille pas son architecture interne : il faut donc raisonner par principe, pas par recette.
Ce principe a trois conséquences concrètes pour votre visibilité :
- Être récupérable d’abord : selon Google, une page doit être indexée et éligible à l’affichage d’un extrait pour apparaître comme lien dans ces fonctionnalités. Aucune optimisation spéciale ni balisage schema.org particulier n’est requis. Les directives nosnippet et max-snippet s’appliquent aussi aux fonctionnalités d’IA.
- Rédiger des passages autonomes : un paragraphe qui répond clairement à une question, nomme les entités et donne ses conditions (date, périmètre, source) est plus facile à extraire et à citer qu’une réponse diluée sur trois écrans.
- Soigner la cohérence factuelle : un système qui récupère plusieurs de vos pages contradictoires peut produire une synthèse confuse. Harmoniser prix, caractéristiques et définitions entre pages devient un enjeu éditorial.
C’est ce que recouvre, en pratique, l’expression « RAG SEO » : travailler vos contenus pour qu’un système de récupération les trouve, les comprenne et les cite correctement. Il ne s’agit pas d’une technique à part, mais d’un travail sur la récupérabilité des pages, la clarté de chaque passage et la cohérence des faits entre vos contenus, que vous pouvez contrôler en vérifiant régulièrement quelles pages sont citées sur vos requêtes prioritaires.
Le sujet n’est plus théorique en France : les AI Overviews et AI Mode y sont disponibles depuis le 22 juillet 2026, et Search Console propose depuis le 31 août 2026 des rapports de performances IA générative, limités aux impressions. Ces signaux s’intègrent dans une stratégie GEO fondée sur la donnée, qui traite ensemble indexation, qualité des passages, entités et mesure.
Méfiez-vous en revanche des promesses d’« optimisation RAG » qui recommandent de découper artificiellement vos pages ou de multiplier les répétitions. Dans son guide d’optimisation pour les fonctionnalités d’IA générative, mis à jour le 10 juillet 2026, Google indique qu’optimiser pour ces fonctionnalités reste du SEO et qu’aucun découpage ni balisage spécial n’est nécessaire. Ces pratiques dégradent en outre l’expérience des lecteurs humains.
05Cas d’usage : knowledge base, contenus et assistants SEO
Le RAG apporte le plus de valeur quand trois conditions sont réunies : un corpus identifié, des questions récurrentes et un besoin de réponses vérifiables.
Assistant interne sur une base de connaissances
Une équipe support, commerciale ou éditoriale pose souvent les mêmes questions : quelle est la politique de retour, quelle gamme est compatible avec tel produit, quelle règle de nommage appliquer aux pages catégories. Un assistant RAG indexé sur la base de connaissances répond en citant le document source, ce qui permet de vérifier en un clic. Pour relier cette base à plusieurs assistants sans intégration spécifique, un serveur MCP qui expose vos ressources documentaires constitue une option à étudier.
Production de contenus fondée sur vos sources
Pour un brief ou un premier jet, le RAG réduit les approximations en imposant au modèle vos propres sources : fiches techniques, études internes, verbatims clients, pages existantes. Le rédacteur garde la main sur l’angle et la vérification, mais part d’une matière exacte. C’est aussi un moyen d’éviter les contradictions avec les contenus déjà publiés, en récupérant les passages existants sur le même sujet avant d’écrire.
Assistant SEO connecté à vos données
Un consultant accumule des audits, des exports Search Console, des crawls et des comptes rendus. Indexés dans un RAG, ces documents permettent de retrouver une recommandation passée, de comparer deux audits ou de préparer un point client à partir de l’historique réel. Associé à un agent capable d’appeler des outils, le dispositif peut aller plus loin, comme le montre notre article sur les agents IA autonomes appliqués au SEO. Les embeddings utilisés pour le RAG servent aussi à d’autres analyses, par exemple pour automatiser un audit sémantique avec embeddings et LLM et regrouper des mots-clés ou des pages par proximité de sens.
Dans n8n, ce type de chaîne se construit avec des nœuds d’embeddings, de découpage de texte et de base vectorielle. Le nœud Simple Vector Store stocke les embeddings dans la mémoire de l’instance : n8n le recommande pour le développement uniquement, car les données sont perdues au redémarrage et tous les utilisateurs de l’instance peuvent y accéder. Pour un usage durable, une base vectorielle dédiée s’impose.
06Limites du RAG et erreurs à éviter
Le RAG peut améliorer nettement la fiabilité des réponses, mais il ne la garantit pas. Les échecs les plus courants sont prévisibles et se préviennent dès la conception.
- Croire que les hallucinations disparaissent : le modèle peut mal lire un passage, combiner deux sources incompatibles ou compléter avec ses propres connaissances. Des instructions explicites et un contrôle humain restent nécessaires sur les réponses à enjeu.
- Indexer un corpus non maîtrisé : documents périmés, doublons et versions contradictoires produisent des réponses incohérentes. La gouvernance documentaire (propriétaire, date de revue, statut) compte davantage que la technologie.
- Négliger le découpage : un tableau coupé en deux, une définition séparée de son exemple ou des passages trop courts faussent la recherche.
- Ignorer le décalage de vocabulaire : si vos utilisateurs disent « remboursement » et vos documents « avoir client », la recherche vectorielle peut rater le bon passage. La recherche hybride et un glossaire aident.
- Oublier les droits d’accès : un assistant ne doit jamais renvoyer un passage qu’un utilisateur n’a pas le droit de lire. Les filtres de permissions doivent s’appliquer au moment de la récupération.
- Sous-estimer l’injection de prompt : un document indexé peut contenir des instructions malveillantes que le modèle risque de suivre, surtout si le corpus inclut des contenus externes. L’OWASP décrit cette injection indirecte, qui passe par des sites ou des fichiers, et recommande une validation humaine pour les actions à risque.
- Ne pas évaluer : sans jeu de questions de référence, impossible de savoir si un changement de découpage ou de modèle améliore ou dégrade le système.
Dans tous les cas, décidez explicitement ce qui peut être délégué à un système automatisé et ce qui doit rester sous contrôle humain, en particulier pour les réponses transmises à des clients ou publiées.
07Mettre en place un premier RAG : méthode pas à pas
Un premier projet doit rester modeste, mesurable et réversible. La méthode suivante convient à une knowledge base interne comme à un assistant SEO.
- Définir le cas d’usage : qui pose quelles questions, et quelle erreur serait inacceptable. Rassemblez une trentaine de questions réelles avec leur bonne réponse et la source attendue.
- Choisir les sources : un périmètre limité, des documents à jour, un propriétaire identifié pour chaque source.
- Nettoyer et découper : retirer le bruit, découper par section logique, ajouter les métadonnées utiles au filtrage et à la citation.
- Indexer : choisir un modèle d’embedding adapté au français et à votre vocabulaire, puis une base vectorielle persistante.
- Régler la récupération : nombre de passages, filtres, recherche hybride si vos contenus contiennent beaucoup de références et de noms propres.
- Rédiger le prompt système : répondre à partir des passages, citer la source, signaler l’absence d’information, refuser les questions hors périmètre.
- Évaluer : pour chaque question de référence, vérifier que la bonne source figure parmi les passages récupérés, puis que la réponse lui est fidèle.
- Mettre à jour et surveiller : réindexation planifiée, journal des questions sans réponse, revue mensuelle des erreurs.
Dans n8n, cette méthode se traduit par deux workflows : un workflow d’ingestion, déclenché à intervalle régulier ou à chaque modification d’un document, qui découpe, calcule les embeddings et alimente la base ; et un workflow de question, qui reçoit la requête, récupère les passages et appelle le modèle. Séparer les deux simplifie le débogage et permet de réindexer sans interrompre le service.
Trois indicateurs suffisent pour piloter les premières semaines :
- le taux de questions pour lesquelles la bonne source est récupérée ;
- le taux de réponses jugées correctes et fidèles à la source par un relecteur ;
- le taux de réponses « information non disponible » justifiées, qui mesure la capacité du système à ne pas inventer.
Le RAG n’est ni une baguette magique ni un gadget. C’est une méthode sobre pour faire travailler un modèle de langage sur des faits que vous maîtrisez, avec des sources visibles et une qualité mesurable. Bien conçu, il améliore vos outils internes ; bien compris, il aide à produire des contenus que les moteurs IA peuvent récupérer et citer sans les déformer.
- arXiv : Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al.) - article présenté à NeurIPS 2020, qui associe une mémoire paramétrique (modèle seq2seq) et une mémoire non paramétrique (index vectoriel de Wikipédia).
- Google Search Central : Fonctionnalités d’IA et votre site Web - query fan-out, page indexée et éligible à un extrait pour apparaître comme lien, aucune optimisation ni donnée structurée spéciale requise, directives nosnippet et max-snippet applicables.
- Google Search Central : Optimizing your website for generative AI features on Google Search - guide mis à jour le 10 juillet 2026 : optimiser pour l’IA générative reste du SEO, aucun découpage ni balisage spécial n’est requis.
- Documentation n8n : Simple Vector Store node - nœud recommandé pour le développement uniquement, données perdues au redémarrage et accessibles à tous les utilisateurs de l’instance.
- OWASP Gen AI Security Project : LLM01:2025 Prompt Injection - l’injection de prompt indirecte passe par des contenus externes et l’OWASP recommande une validation humaine pour les actions à risque.